1994년, 사람의 말을 이해하는 인공지능을 만들겠다는 목표로 출발한 씨엠씨테크가 32년째 이어 온 연구의 결실입니다. 정석과 사람의 로직으로 사람의 방식대로 두는 레벨 1, 신경망과 가중치로 AI의 방식대로 두는 레벨 2, 그리고 의미의 객체로 스스로 '왜'를 아는 바둑을 연구하는 레벨 3(LOM). 회사의 역사와 인공지능의 역사, 그리고 워드고가 택한 길을 처음부터 들려드리겠습니다. 푸른 점선이 있는 낱말은 누르면 뜻과 원 논문을 볼 수 있습니다.
딱. 당신이 우상귀 화점에 흑돌을 내려놓습니다. 화면에는 아무 일도 없는 것처럼 보입니다. 그러나 그 순간, 당신의 컴퓨터 안에서 작은 엔진 하나가 깨어납니다.
엔진은 먼저 오래된 책을 펼칩니다. 25년 전부터 사람이 한 수 한 수 정리해 온 정석 사전입니다. "이 자리는 화점. 여기서는 걸침이나 마주 보는 화점이 자연스럽다." 다음에는 판을 훑으며 급한 곳을 찾습니다. 단수에 걸린 돌은 없는지, 축으로 잡히는 돌은 없는지. 그리고 남은 시간 동안 머릿속에서 수만 판의 바둑을 끝까지 두어 봅니다.
2초가 지나면 백돌 하나가 놓이고, 화면 아래에 짧은 문장이 뜹니다.
【워드고】 D4 화점 — 마주 보는 화점으로 귀를 나눕니다 · 수읽기 9,000판 · 백 승률 49%
이 한 줄이 워드고의 전부를 담고 있습니다. 어디에 두었는지, 그 수의 이름이 무엇인지, 왜 두었는지, 얼마나 읽었는지. 강한 바둑 AI는 이미 많습니다. 그러나 자기가 둔 수를 사람의 말로 설명하는 AI는 드뭅니다. 워드고는 바로 그 일을 하려고 태어났습니다. 그리고 그 뿌리는 32년 전, 바둑이 아니라 말에서 시작되었습니다.
CHAPTER 01
1994년부터 시작된 씨엠씨테크의 AI 개발 여정, 32년
씨엠씨테크는 1994년에 문을 연 작은 인공지능 연구소에서 출발했습니다. 올해로 32년째입니다. 처음 목표는 분명했습니다. 사람의 자연어를 있는 그대로 인지하는 인공지능. 첫 걸음은 번역 프로그램 아바토(ABBATO)였습니다. 프로그램은 완성되었지만 당시의 기술 수준으로는 만족스럽지 않아 발표하지 않았습니다.
씨엠씨테크는 아바토만 연구하지 않았습니다. 같은 시기에 더 규격화된 인공지능 연구 대상으로 바둑을 골랐습니다. 1997년 IBM의 딥블루가 체스 세계 챔피언을 이긴 일에 자극을 받았기 때문입니다. "체스 다음은 바둑이다. 컴퓨터가 사람을 이기는 바둑을 만들겠다. 그러려면 인공지능이 필요하다." 말을 이해하는 아바토와 사람을 이기는 바둑 대국, 이 두 가지가 씨엠씨테크 연구의 두 기둥이 되었습니다. 그리고 두 연구에서 같은 깨달음이 남았습니다.
"로직만으로는 안 된다. 데이터가 필요하다."
바둑은 규칙이 몇 줄이지만, 그 안에서 벌어지는 일은 사람의 말만큼 깊습니다. 규칙(로직)을 아무리 정확히 적어도 '좋은 수'는 나오지 않았습니다. 좋은 수는 사람이 수백 년 동안 두어 온 경험 속에 있었습니다. 그래서 씨엠씨테크는 30년 전에 이미 결론을 냈습니다. 인공지능에는 로직과 함께 데이터가 있어야 한다. 그때부터 정석과 기보를 모으고 정리하는 일이 시작되었습니다.
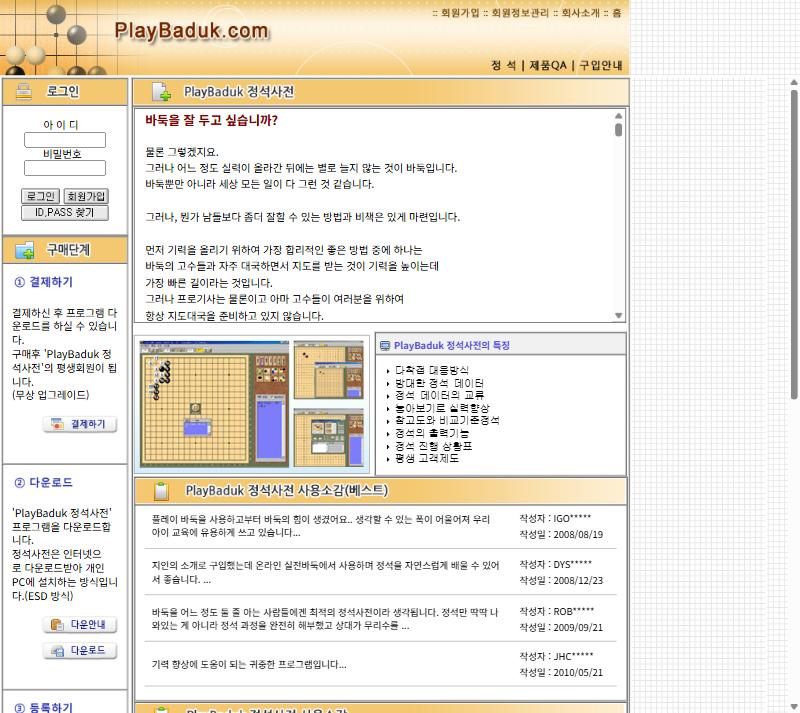
그 결실이 2001년의 정석사전입니다. 귀의 첫 수부터 끝까지 서로 최선을 다한 수순을 컴퓨터에 담고, 수마다 해설을 붙였습니다. 정석사전과 바둑 기보를 함께 팔았고, 내려받아 설치하는 프로그램이었습니다. 그 설명과 등록을 맡기려고 만든 홈페이지가 바로 지금의 playbaduk.com 입니다 — 25년이 지난 오늘도 같은 주소에서 같은 화면이 돌고 있습니다.
바둑은 상품을 만들거나 대회에 나가기 위한 것이 아니라 순수한 연구 대상이었습니다. 연구 자금은 기업의 정보화 시스템(ERP 등)을 만들어 팔아 마련했습니다. 한쪽 손으로는 기업 시스템을 짓고, 다른 손으로는 바둑과 말을 연구하며 회사를 이어 왔습니다.
1990년대의 두 갈래. 왼쪽 는 스스로 인지하는 기계를, 오른쪽 는 통계로 과제를 푸는 도구를 뜻했습니다. 씨엠씨테크는 왼쪽에 무게를 두었습니다.
PLAYBADUK 의 역사
2001년 홈페이지 → AI 연구의 도구 → 2026년 씨엠씨테크 AI
2026년 10월 28일에 찍은 playbaduk.com. 2001년에 만든 홈페이지가 그대로입니다 — 왼쪽의 로그인·구매 단계·내려받기, 가운데의 정석사전 소개와 2008~2010년 사용 소감까지.
인터넷에 처음 남은 발자국
인터넷 아카이브(archive.org)의 웨이백 머신은 전 세계 웹 페이지를 날짜별로 자동 저장해 두는 비영리 디지털 도서관입니다. 거기에 남은 playbaduk.com의 가장 오래된 저장본이 2001년 5월 21일입니다. 그날 첫 화면의 공지는 "사이버 바둑학교 홈페이지가 PlayBaduk.com의 새 서버로 옮겨 왔다"는 것과 "사이버 바둑학교 1.02 정식 발표"였고, 맨 아래에는 Programmed By CmcTech가 적혀 있었습니다.
"세계 최강의 대국 프로그램을 만들어 가겠습니다"
2002년 저장본의 'AI' 메뉴에는 대표 인사말이 있습니다. 회사가 오래전부터 인공지능을 연구해 왔고, 그 적용 대상으로 바둑 같은 지능 게임과 자동 번역·통역을 골랐으며, 번역 프로젝트는 오래전부터 진행 중이고, 바둑은 정석·기보 데이터 작업을 하다가 이제 인공지능 대국 프로그램 개발 프로젝트를 시작한다는 내용입니다. 당시 국내외 바둑 프로그램의 기력이 7~8급에도 못 미친다는 진단과, 베타테스트로 개발 과정을 공개하겠다는 약속도 함께 적혀 있습니다. 24년 뒤 워드고가 하는 일이 이미 그 글에 있었습니다.
정석사전, 그리고 AI 연구의 도구로
정석사전은 2.5판까지 자라 정석 1만 7천여 개, 변화 장면 15만 가지, 해설 2만 8천 개를 담았습니다. 사용 소감란에는 2008년부터 2010년까지의 회원 글이 남아 있습니다. 이 자료는 판매용이면서 동시에 씨엠씨테크가 "데이터가 필요하다"고 판단해 모은 AI 연구의 재료였고, 지금 워드고의 첫 수를 이끕니다.
씨엠씨테크 AI — 같은 주소, 새 엔진
2026년 PlayBaduk은 바둑 마을과 3D 대국실, 웹 정석 사전으로 다시 태어났고, 그 안에서 워드고가 사람과 바둑을 둡니다. 25년 전 홈페이지가 설명하던 '정석사전'은 이제 엔진 안으로 들어갔습니다.
사람의 자연어를 인지하는 인공지능을 목표로 작은 연구소를 열었습니다. 첫 걸음은 번역 프로그램 아바토(ABBATO). 완성했지만 수준이 낮아 발표하지 않았습니다.
바둑을 고르다 — "데이터가 필요하다"
다음 연구 대상으로 바둑을 골랐습니다. 로직만으로는 안 된다는 것을 알고, 30년 전에 이미 정석과 기보 데이터를 모으기 시작했습니다.
정석사전 발표 · playbaduk.com
정석사전과 기보를 내려받아 설치하는 프로그램으로 팔았습니다. 설명과 등록을 맡은 홈페이지가 지금의 playbaduk.com — 오늘도 같은 화면입니다.
AI 대국 프로그램 프로젝트 선언
홈페이지 인사말로 "인공지능 대국 알고리즘의 새로운 설계"를 공개 약속했습니다. 당시 세계의 바둑 프로그램은 7~8급에도 못 미쳤습니다.
알파고, 그리고 다시 바둑으로
알파고가 이세돌 9단을 이긴 뒤 씨엠씨테크는 바둑에 다시 관심을 두었습니다. "바둑이 AI 시대의 물꼬를 텄다."
씨엠씨테크 AI · 워드고
올해부터 예전의 강한 AI 구상을 지금의 LLM을 도구 삼아 구현합니다. 그 첫 결실이 워드고이고, 같은 기술을 기업 정보 통합 시스템 CMC-EIMS에도 적용하고 있습니다.
2026년의 방법. 생각한 것을 LLM이라는 도구로 바로 짜고, 바로 시험합니다. 수백 명의 코더와 일하는 것과 같습니다.
재야(在野)의 시간, 그리고 2026년
작은 연구소로 출발한 씨엠씨테크는 25~30년 전에는 이름이 알려졌지만, 그 뒤로는 드러내지 않고 조용히 연구만 이어 왔습니다. 대표의 표현을 빌리면 재야(在野)의 시간 — 앞에 나서지 않고 들판에 머물며 연구에만 몰두한 시간입니다. 그 사이 세상은 두 번 바뀌었습니다. 2016년 바둑에서, 2017년 언어에서.
AI 시대가 본격화된 지 3~4년. 씨엠씨테크는 그 흐름을 거꾸로 이용하기로 했습니다. 남들이 공개된 모델을 그대로 가져다 쓰는 동안, 씨엠씨테크는 예전의 강한 AI 구상 — 인지력을 갖게 하는 로직 — 을 구현하는 데 지금의 을 도구로 씁니다. 생각한 것을 수백 명의 코더를 데리고 일하듯 바로 구현하고 시험할 수 있기 때문입니다. 워드고 역시 처음 생각한 기법으로 밀고 갑니다. 우리의 개념을 잘 주입하니 결과가 잘 나오고 있어, 다음 단계를 기대하고 있습니다.
CHAPTER 02
바둑이 AI 시대의 물꼬를 텄다 — 인공지능 70년
워드고를 이해하려면 인공지능이 걸어온 길을 알아야 합니다. 특히 그 길의 한가운데에 바둑이 있었다는 것을.
인공지능 70년 — 로직, 통계, 그리고 바둑누르면 그 시대로 내려갑니다
① 로직의 시대 — 강한 AI를 꿈꾸다
1950년 앨런 튜링은 "기계는 생각할 수 있는가"를 물었고, 1956년 다트머스 회의에서 '인공지능'이라는 말이 태어났습니다. 초기 인공지능은 기호와 로직이었습니다. 규칙을 적고, 추론하고, 전문가의 지식을 '만약 ~라면' 규칙으로 옮겼습니다. 1980년 철학자 존 설은 이 꿈을 두 갈래로 나눴습니다. 사람처럼 이해하고 인지하는 기계를 만들겠다는 , 그리고 이해 없이 과제만 잘 푸는 . 1994년의 씨엠씨테크는 망설임 없이 앞쪽을 골랐습니다. 사람의 말을 자연스럽게 인지하는 로직을 연구했고, 통계로 번역하는 당시의 방법은 약한 AI로 보았습니다.
② 통계와 신경망 — 데이터가 로직을 앞지르다
1986년 로 여러 층의 을 학습시키는 길이 열렸고, 1997년 IBM 딥블루는 체스 세계 챔피언을 이겼습니다. 그러나 바둑은 달랐습니다. 체스보다 경우의 수가 비교할 수 없이 많아, 힘으로 다 읽는 방법이 통하지 않았습니다. 2006년 과 가 나오면서 바둑 프로그램은 겨우 아마추어 단 수준에 올랐습니다. 워드고 레벨 1이 쓰는 바로 그 방법입니다.
③ 2016년 3월, 바둑이 문을 열다
2014년 구글이 인수한 딥마인드는 2016년 1월 《네이처》에 논문을 냈고, 같은 해 3월 서울에서 이세돌 9단을 4대 1로 이겼습니다. 신경망의 감각과 트리 탐색의 수읽기를 합친 결과였습니다. 세상은 이 대국을 보고 깨달았습니다. 데이터로 배운 기계가 사람의 직관을 넘을 수 있다. 씨엠씨테크는 이 사건을 "바둑이 AI 시대의 물꼬를 텄다"고 부릅니다. 투자와 인재와 관심이 한꺼번에 인공지능으로 쏟아진 출발점이기 때문입니다.
④ 2017년, 어텐션 — 말이 열리다
이듬해 구글의 연구자 여덟 명이 논문 "Attention Is All You Need"를 발표했습니다. 문장의 낱말들이 서로 무엇에 얼마나 주목할지를 스스로 정하는 만으로 번역을 해낸 것입니다. 예전에 약한 AI로 분류되던 통계적 자연어 처리와 번역이 이 기법으로 일반화되었고, 그 위에서 오늘의 이 태어났습니다. 아바토가 32년 전에 하려던 일이 다른 길로 이루어진 셈입니다.
⑤ 그러나 — 왜 아는지 모르는 기계
LLM은 놀랍도록 잘 말하지만, 자기가 왜 아는지는 모릅니다. 답은 통계로 이어 붙인 것이고, 그 근거를 스스로 짚을 수 없어 그럴듯한 거짓을 만들어 냅니다. 이것이 입니다. 강한 AI가 꿈꾸던 '이해'는 아직 거기에 없습니다. 씨엠씨테크는 바로 이 틈에서 워드고를 시작했습니다. 로직이 사실을 세우고, 데이터가 감각을 주고, 어텐션이 둘을 잇되 어디를 보았는지가 그대로 남는 AI. 바둑은 그 생각을 시험하기에 가장 좋은 닫힌 세계입니다.
棋
바둑이 연 문
2016년 3월 알파고 대 이세돌. 체스(1997)로는 열리지 않던 세계의 관심이 바둑으로 열렸습니다.
語
말이 이어받은 길
2017년 트랜스포머·어텐션. 바둑에서 증명된 '데이터로 배우는 직관'이 언어로 옮겨 갔습니다.
?
남은 질문
왜 그런 답인지 기계가 말하지 못한다는 것. 워드고는 이 질문에서 출발합니다.
기록으로 확인한 날짜
알파고 대 이세돌 2016년 3월 9~15일(4:1) · 알파고 논문 《네이처》 2016년 1월 28일 · 트랜스포머 논문 2017년 6월, 구글 브레인·구글 리서치 저자 8명 · 구글의 딥마인드 인수 2014년 1월. 용어 사전에 원 논문이 있습니다.
CHAPTER 03
왜 PlayBaduk은 워드고를 만들었을까
2016년 이후 바둑 AI는 사람보다 훨씬 강해졌습니다. 그런데 이상한 일이 생겼습니다. AI가 둔 수를 보고 사람들은 이렇게 묻습니다. "그래서, 왜 거기에 둔 거지?"
지금의 AI는 그래픽 카드로 엄청난 양의 통계를 쌓아 답을 냅니다. 답은 강하지만, 왜 그런 답이 나왔는지는 AI 자신도 말하지 못합니다. 씨엠씨테크는 1994년의 생각으로 돌아갔습니다. 로직을 먼저 세우자. 바둑은 규칙이 닫혀 있고 정답을 계산할 수 있는 세계입니다. 단수, 축, 사활, 정석처럼 사람이 수백 년 동안 다듬어 온 개념을 계산으로 정확하게 세우고, 그 위에 학습을 얹으면, 그래픽 카드를 훨씬 적게 쓰면서도 왜 그 수인지 아는 AI를 만들 수 있다고 보았습니다.
이름도 그래서 워드고(Word + Go)입니다. 바둑 수 하나하나에 이름과 이유를 붙이는 AI, 그리고 앞으로 PlayBaduk의 낱말 놀이 세계 '단어성'과 이어질 AI입니다. 남들이 공개 모델을 그대로 베끼는 동안 워드고는 처음 생각한 방식으로 갑니다. 사람처럼 두는 바둑은 레벨 1이, AI처럼 두는 바둑은 레벨 2가 맡습니다. 실력은 말이 아니라 숫자로만 증명합니다.
말
이유를 말합니다
수의 이름(걸침·협공·젖힘), 두는 뜻, 읽은 수순과 승률을 문장으로 보여 줍니다. 상대가 둔 수도 바로 해설합니다.
집
내 컴퓨터에서 생각합니다
레벨 1·2는 회원의 브라우저 안에서 계산합니다. 회원이 늘어도 서버가 무거워지지 않고, 바둑판 앞에서 바로 답합니다.
급
내 실력에 맞춥니다
대국실에서는 18급부터 아마 3단까지 레벨 1이, 아마 4단부터 프로 9단까지 레벨 2가 먼저 나섭니다. 어느 단계에서든 다른 레벨로 바꿔 고를 수 있습니다.
CHAPTER 04
레벨 1 · 2 · 3 — 사람의 방식, AI의 방식, 그리고 객체의 방식
워드고는 이름은 하나지만, 바둑을 생각하는 방식이 서로 다른 세 단계로 이루어져 있습니다. 세 단계를 가르는 기준은 강하고 약함이 아니라 수를 고르는 원리입니다. 레벨 1은 사람의 방식입니다. 정석을 쓰고, 사람이 바둑을 생각하는 순서대로 짠 로직으로 수를 풀어냅니다. 레벨 2는 AI의 방식입니다. 처음부터 (합성곱과 가중치)을 워드고의 수읽기 엔진에 직접 연결해, 판단의 중심을 데이터로 다듬은 감각에 둡니다. 레벨 3은 객체의 방식입니다. 아바토의 ONI(Object Net Intelligent)에서 출발해, 그 연구의 보조 명칭인 LOM(Large Object Model)의 인식·프로그램·신경선 개념을 바둑에 적용하려는 방향입니다.
세 단계는 같은 바둑판, 같은 규칙, 같은 해설 틀을 함께 씁니다. 그래서 같은 급수로 맞추어 두어도 차이가 실력이 아니라 기풍으로 드러납니다. 대국실에서는 18급부터 아마 3단까지 레벨 1이, 아마 4단부터 프로 9단까지 레벨 2가 먼저 나섭니다. 어느 급수에서든 다른 레벨을 골라 두 방식을 직접 견주어 볼 수 있습니다. 왜 이렇게 나누었는지는 다음 장에서 설명합니다.
레벨 1 · 사람의 방식
정석 + 사람의 로직
정석 사전으로 초반을 열고, 사람이 생각하는 순서(급한 수 → 모양 → 수읽기)로 짠 로직으로 둡니다. 신경망을 쓰지 않습니다. 목표: 아마 1급 → 아마 3단 → 최고 아마 5단.
회원 브라우저 · 대국실 기본 18급~아마 3단 · 지금 3급과 대등, 아마 1단 목표레벨 2 · AI의 방식
신경망 + 워드고 수읽기 엔진
합성곱·어텐션 가중치의 신경망을 처음부터 워드고 수읽기 엔진에 연결한 단계입니다. 판단의 중심이 데이터로 다듬은 감각에 있습니다. 목표: 프로 9단 설정을 넘어 최강 공개 AI와 대등.
브라우저 WebGPU · 대국실 기본 아마 4단~프로 9단레벨 3 · 객체의 방식
LOM — Large Object Model
ONI에서 이어 온 인지 연구. 의미와 목적을 가진 객체에 판단 프로그램을 담고, 신경선과 이유 기록으로 수의 근거를 연결하려 합니다.
ONI의 인지 구조를 바둑에 적용하는 연구
CHAPTER 05
누구에게 배우는가 — 레벨 1과 레벨 2를 나눈 이유
사람은 보통 바둑을 선생님에게, 혹은 자기보다 조금 더 잘 두는 사람에게서 배웁니다. 선생님은 수를 가르칠 때 이유를 함께 가르칩니다. "귀는 먼저 차지하는 쪽이 크다", "끊는 곳을 먼저 살펴라", "두터운 쪽에서 싸워라". 이런 격언과 정석은 수백 년 동안 사람이 바둑을 이해해 온 방식이고, 사람의 기억과 계산 능력에 맞추어 다듬어진 지식입니다.
AI와 두며 바둑을 배우면 이야기가 달라집니다. 신경망 바둑 AI는 사람이 쓴 격언에서 출발하지 않고, 수백만 판이 넘는 자기 대국에서 통계적으로 이기는 수를 찾아냈습니다. 그래서 2016년 이후 프로 바둑에서도 귀의 3·3 침입을 이른 시기에 두거나, 예전에는 '좋지 않다'고 배운 어깨짚기를 서슴없이 두는 등 낯선 수가 크게 늘었습니다. 실제로 1950년부터 2021년까지 프로 기사 580만 수를 분석한 연구는, 알파고 등장 뒤 사람의 수가 더 좋아졌을 뿐 아니라 이전에 없던 새로운 수가 뚜렷이 늘었다고 보고했습니다[6]. 처음부터 AI에게서 배우면 처음부터 AI의 방식으로 바둑을 익히게 됩니다. 그것이 좋은지 나쁜지는 아직 아무도 모릅니다. 다만 다르다는 것은 분명합니다.
사람에게 배우는 길
선생님격언 · 정석 · 이유사람의 기풍
워드고 레벨 1
정석을 쓰고, 사람이 생각하는 로직으로 수를 풉니다. 이유를 말로 들려줄 수 있는 상대.
AI에게 배우는 길
신경망수의 확률 · 승률AI의 기풍
워드고 레벨 2
신경망의 감각을 수읽기 엔진이 깊게 확인합니다. 승률로 판단하는 상대.
같은 급수, 다른 기풍
워드고는 두 길을 일부러 나눕니다. 레벨 1과 레벨 2를 같은 1급으로 맞추어 두어도, 레벨 1은 사람처럼 정석을 따라가며 두고, 레벨 2는 AI처럼 승률이 가장 높은 길을 고릅니다. 겉으로는 같은 'AI 상대'처럼 보이지만 기풍이 전혀 다릅니다.
PlayBaduk이 바라는 배움의 순서는 이렇습니다. 먼저 레벨 1과 두며 사람의 방식으로 바둑을 배웁니다. 정석의 뜻, 급한 수의 이유, 모양의 좋고 나쁨을 사람의 말로 익힙니다. 그 다음 레벨 2와 두며 AI의 방식이 어떻게 다른지 직접 느낍니다. 같은 장면에서 사람의 상식과 AI의 판단이 갈라지는 곳이 바로 오늘의 바둑이 새로 배우고 있는 자리이기 때문입니다.
이 생각은 체스 연구와도 맞닿아 있습니다. 최강 체스 AI를 흉내 내지 않고 급수별 사람의 수를 예측하도록 만든 엔진(Maia)은, 같은 급수의 사람이 실제로 둘 수를 훨씬 잘 맞혔습니다[5]. 사람처럼 두는 상대와 AI처럼 두는 상대는 서로 다른 교육적 가치를 가집니다. 워드고는 둘을 한 화면 안에 함께 둡니다.
레벨 1 · 사람의 방식
정석 사전 — 화점에 다가가는 정석 후보 4개
로직 — 급한 수 없음, 큰 자리 순서
모양 — 기보에서 가장 흔한 걸침
R14 날일자 걸침 · "귀를 나누어 갖자"
레벨 2 · AI의 방식
신경망 — 판 전체의 수 확률(밝을수록 유력)
수읽기 — 유력한 길을 수백 번 깊게 확인
승률 — 가장 높은 길을 고름
R17 3·3 침입 · "지금 바로 귀의 실리를"
같은 장면, 두 대답. 흑 화점(Q16)에 백이 다가가는 장면에서 레벨 1은 오랜 정석인 날일자 걸침을, 레벨 2는 AI 시대에 널리 퍼진 이른 3·3 침입을 고르는 모습입니다. 두 방식의 차이를 보여 주는 설명용 그림이며, 실제 대국 기록이 아닙니다.
CHAPTER 06
레벨 1 — 사람의 방식으로 두는 바둑
레벨 1은 씨엠씨테크가 오래전부터 개발해 온 바둑 로직을, 이번에 AI를 도구 삼아 C++ 코드로 다시 정리한 엔진입니다. 신경망이 바둑을 바꾸기 전, 사람이 짜는 코딩 기법 그대로 만든 엔진입니다. 핵심은 사람이 바둑을 배우고 생각하는 순서를 그대로 계산으로 옮긴 데 있습니다. 초반에는 정석을 쓰고, 그 다음은 급한 수를 먼저 살피고, 좋은 모양을 고르고, 수읽기로 확인합니다. 사람 선생님이 가르치는 순서와 같습니다. 그래서 레벨 1은 사람처럼 두고, 수마다 사람의 말로 이유를 댈 수 있습니다.
레벨 1은 신경망 가중치를 쓰지 않습니다. 이 제약은 일부러 둔 것입니다. 사람의 방식만으로 어디까지 갈 수 있는지를 재는 것이 레벨 1의 연구 질문이기 때문입니다. 목표는 단계적으로 아마 1급 → 아마 3단 → 최고 아마 5단입니다. 지금 실력은 급수별로 사람처럼 두는 공개 AI 상대와의 자동 대국 기준 3급과 대등한 데까지 확인했고, 기보를 학습 자료로 넣은 로직 엔진으로 아마 1단을 향해 올리고 있습니다. 실력을 올리는 것은 모양 학습이고, 숫자를 올리지 못한 로직 실험은 쓰지 않습니다. 한 수를 고르는 길은 다섯 단계입니다.
1정석 사전25년 정석 + AI 정석
2급한 수 로직따냄·단수·축·끊김
3기보 모양고수가 자주 둔 모양
4수읽기C++ 몬테카를로 탐색
5해설이름·이유·수순
사람의 방식 ①
아는 길을 먼저
사람은 처음 보는 장면에서도 배운 정석과 격언에서 출발합니다. 레벨 1도 정석 사전과 기보의 모양을 먼저 후보로 세우고, 그 밖의 수는 뒤에 살핍니다. 그래서 초반이 낯익고, 왜 그 수인지 정석의 이름으로 말할 수 있습니다.
사람의 방식 ②
급한 것부터
사람은 판 전체를 한꺼번에 계산하지 못하므로 "단수인가, 끊기는가, 잡히는가"처럼 급한 것부터 확인합니다. 레벨 1의 급한 수 로직이 바로 이 순서입니다. 계산이 짧은 대신 판단의 근거가 분명합니다.
사람의 방식 ③
모양의 감각
사람은 수많은 대국을 두며 '좋은 모양'의 감각을 얻습니다. 레벨 1은 이 감각을 기보의 작은 모양 점수로 배웁니다. 신경망처럼 판 전체를 보는 감각은 아니지만, 사람이 이름 붙인 모양(호구·빈삼각·날일자)과 같은 단위입니다.
① 25년의 정석이 첫 수를 이끕니다
초반의 귀는 워드고가 가장 자신 있는 곳입니다. 정석사전 2.5의 사람 정석 14만 9,768장면과, PlayBaduk이 AI로 검증해 새로 만든 AI 정석 8,258장면을 하나로 묶은 책입니다.
25년 전 정석 자료는 모든 수순을 왼쪽 위 귀 하나를 기준으로 적었습니다. 실제 판에는 귀가 넷이고, 대각선으로 뒤집은 모양까지 치면 여덟 방향이 있습니다. 워드고는 판 위의 귀를 여덟 방향으로 돌려 보며 사전과 맞추고, 상대가 손을 빼면 그것까지 따라갑니다. 사람 정석과 AI 정석이 같은 수를 가리키면 그 수에 1.5배 점수를 줍니다.
정석은 명령이 아니라 '먼저 살펴볼 후보'입니다. 마지막 판단은 언제나 수읽기가 합니다.
같은 날일자 걸침 정석 하나를 여덟 방향으로 돌린 모습. 사전에는 하나로 적혀 있지만, 판에서는 여덟 가지로 나타납니다.
축: 흑이 번갈아 단수를 치면 백 돌은 판 끝까지 도망가다 잡힙니다.
② 바둑 개념을 계산으로
"축으로 몰면 잡히는가?" 사람은 눈으로 그려 보며 답을 찾습니다. 워드고는 같은 질문을 재귀 수읽기로 정확하게 계산합니다. 왼쪽 그림의 백 돌이 판 끝까지 쫓겨 가는 모습이 바로 워드고가 머릿속에서 확인하는 장면입니다.
따냄, 단수 탈출, 축으로 잡기와 피하기, 끊김 막기, 눈 모양과 급소, 집과 세력의 어림. 이런 개념들이 '급한 수 로직'이 되어, 큰 돌이 걸린 수는 수읽기 전에 먼저 후보로 올라옵니다. 이것이 1994년부터 이어 온 CMC 로직의 바둑판입니다 — 기계가 '왜'를 아는 부분.
③ 기보에서 '좋은 모양'을 배웁니다
고수들은 같은 모양에서 비슷한 수를 둡니다. 워드고는 기보 149판, 4만 3,891수를 읽고 돌 주변의 작은 모양 1만 4천 가지에 점수를 매겨 씁니다. 3×3 모양에서 시작해, 더 넓은 12점 마름모 모양까지 넓혔습니다.
이 방법은 알파고 이전 최강 프로그램 Crazy Stone의 개발자 레미 쿨롱(Rémi Coulom)이 2007년에 발표한 과 같은 계열입니다. 효과는 숫자로 나타납니다. 모양 학습을 넣은 판은 이전 판에게 12판 중 8~9판을 이깁니다.
가운데 빈 점에 둘지 말지를 정할 때 보는 주변 모양. 왼쪽 3×3, 오른쪽 12점 마름모.
0판째 읽는 중 · 원이 클수록 많이 읽은 수, 초록일수록 이기는 수
④ 2초 동안 수만 판을 끝까지 두어 봅니다
후보가 모이면 이 시작됩니다. 한 후보를 골라 판이 끝날 때까지 빠르게 두어 보고, 이기면 그 길에 점수를 더합니다. 좋아 보이는 길은 더 깊이, 덜 읽은 길은 가끔씩 다시 확인합니다(). 왼쪽 나무가 자라는 모습이 그 과정입니다.
알파고 이전의 강한 바둑 프로그램들, 곧 Crazy Stone, MoGo, Zen과 많은 상용 바둑 프로그램이 대부분 이런 방식을 썼습니다. 워드고 레벨 1은 이 검증된 뼈대 위에 25년의 정석과 바둑 개념 로직을 얹은 엔진입니다.
수읽기 본체는 C++로 쓰여 있습니다. 같은 코드가 서버에서는 여러 코어로, 브라우저에서는 로 돕니다. JavaScript로만 쓴 판보다 수십 배 빠릅니다.
2초 동안 끝까지 둬 보는 판 수7호 서버(라이젠 5 5600G) · 브라우저는 회원 PC 4코어 기준
17급에서 아마 1단으로 — 레벨 1이 자라 온 길
레벨 1은 한 번에 만들어지지 않았습니다. 처음에는 바둑 개념 로직만으로 두었습니다. 단수·축·끊김을 계산하는 로직과 짧은 수읽기만으로 17급 안팎, 수읽기를 보강해 13급 안팎까지 올랐습니다. 다음으로 25년의 정석 사전을 쓰기 시작하자 초반이 단단해져 5급 근처에 이르렀고, 기보에서 좋은 모양을 학습하자 3급과 대등하게 두었습니다.
지금은 아마 1단을 목표로, 기보를 학습 자료로 넣어 수를 보는 로직 엔진을 새로 다듬고 있습니다(엔진 1.50). 측정으로 확인한 것은 3급과 대등한 데까지이며, 1급과 1단은 지금 측정하고 있습니다. 실력은 단계마다 급수별로 사람처럼 두는 공개 AI '사람 모델'과 자동 대국을 두어 잽니다. 흑백을 바꿔 가며 두고, 판이 끝나면 강한 AI가 형세를 판정합니다. 효과가 없는 실험은 숫자를 보고 과감히 버립니다.
단계
이때 한 일
실력(자동 대국 측정)
① 로직만
단수·축·끊김·사활을 계산하는 바둑 개념 로직 + 짧은 수읽기
17급 안팎
② 로직 + 수읽기 보강
몬테카를로 수읽기를 C++로 새로 쓰고 급한 수 판단을 고침
13급 안팎 → 7급 상대 우세
③ 정석 사용
25년 정석 사전(14만여 장면)을 여덟 방향으로 맞춰 초반에 사용
5급 근처
④ 기보 모양 학습
기보에서 3×3 · 12점 마름모 모양에 점수를 매겨 후보를 고름
3급과 대등
⑤ 기보 + 로직 엔진
기보를 학습 자료로 넣어 수를 보는 로직 엔진(1.50)
목표 아마 1단 · 측정 중
CHAPTER 07
AI와 함께 AI를 만든 방법
워드고는 사람의 구상과 AI 개발자의 손이 함께 만든 엔진입니다. 방향은 씨엠씨테크 대표가 정하고, 코딩은 AI 개발자 Claude가 주로 맡고, 또 다른 AI 개발자 Codex가 시험하고 놓친 곳을 짚습니다. 1장에서 말한 '수백 명의 코더'가 바로 이것입니다. 모든 결정은 하나의 원칙을 따랐습니다. "실력은 말이 아니라 숫자로."
수천 판의 자동 대국
7호 서버가 밤낮으로 워드고와 '사람 모델'(18급~9단)의 대국을 둡니다. 새 기능은 이 대국에서 이겨야만 채택됩니다.
버린 실험도 기록합니다
예: '활로 둘인 큰 무리 수읽기'는 12판 6승 6패로 효과가 없어 쓰지 않습니다. 로직 힌트의 양도 실력을 가르지 않습니다.
버전마다 지문을 남깁니다
버전을 올릴 때마다 모든 파일을 지문(SHA-256)과 함께 보관하고, 측정 숫자를 변경 기록에 적습니다.
학습 전용 서버
8호 서버는 학습만 맡습니다. 급수별 기보 생성기가 시간당 약 1,200판을 두고, 8호가 그 기보로 레벨 2를 급수마다 다듬습니다.
CHAPTER 08
레벨 2 — AI의 방식으로 두는 바둑
레벨 2는 처음부터 을 워드고의 수읽기 엔진에 직접 연결한 워드고입니다. 여기에는 오늘의 AI를 만든 기법이 모두 들어 있습니다. 알파고가 보여 준 딥러닝 신경망(합성곱), 그리고 대형 언어 모델()을 만든 토큰화와 입니다. 판단의 중심이 사람이 쓴 규칙이 아니라 데이터로 다듬은 감각에 있으므로, 레벨 2는 완전히 AI의 방식으로 둡니다.
이미 공개된 여러 바둑 AI 가운데, LLM의 기법인 어텐션(트랜스포머) 신경망을 실제 대국 수준으로 학습해 가중치까지 공개한 것이 있습니다. 워드고는 그 공개 가중치를 가져와, 워드고가 C++로 새로 쓴 수읽기 엔진( 탐색)과 브라우저 실행기()에 연결한 자체 엔진입니다. 레벨 1의 정석·기보·로직을 신경망과 섞는 방법 열두 가지는, 같은 상대·같은 조건의 자동 대국에서 '신경망만'을 확실히 넘지 못합니다. 실력을 올리는 것은 섞는 방법이 아니라 신경망 재료(가중치)의 크기와 읽기 횟수입니다. 그래서 레벨 2는 AI의 방식을 끝까지 따르고, 사람의 방식은 레벨 1이 온전히 맡습니다.
1지금 판361개 점을 숫자 판(토큰)으로
2신경망합성곱 + 어텐션 가중치
3수 확률 · 승률판 전체를 한 번에 판단
4워드고 수읽기유력한 길을 수백 번 깊게
5엔진 조정 · 해설급수 맞춤, 승률과 수순을 말로
신경망과 어텐션 — 같은 신경망, 다른 처리 방법
어텐션도 신경망의 한 종류입니다. 차이는 한 점이 어디까지를 보느냐에 있습니다.
합성곱(Convolution) 층은 한 점을 계산할 때 그 점을 둘러싼 3×3, 곧 자기와 이웃 여덟 점만 봅니다. 이 작은 창을 판 전체에 미끄러뜨리며 '붙음', '젖힘', '호구' 같은 작은 모양을 읽고, 층을 수십 겹 쌓아 올리며 점점 넓은 모양을 봅니다. 사람이 눈앞의 모양부터 읽어 나가는 것과 비슷합니다. 알파고 이후의 바둑 AI는 대부분 이 방식이었습니다.
어텐션(Attention) 층은 한 점을 계산할 때 판 위 361개 점 모두와의 관계 점수를 한 번에 매깁니다. 점마다 '나는 무엇을 찾는가(질의)'와 '나는 무엇인가(키)'를 숫자로 만들고, 둘의 내적으로 관계의 세기를 잰 뒤 softmax로 비율(가중치)을 정해, 관계가 큰 점의 정보를 더 많이 가져옵니다. 그래서 판의 반대쪽 끝에 있는 축머리나, 멀리 떨어진 두 무리의 사활 관계를 층 하나에서 곧바로 봅니다. 문장에서 멀리 떨어진 낱말 사이의 관계를 찾던 LLM의 방법이 바둑판에서는 '멀리 있는 돌 사이의 관계'가 됩니다[4].
레벨 2가 쓰는 어텐션 신경망은 두 층을 함께 씁니다. 합성곱으로 가까운 모양을 읽고, 어텐션으로 판 전체의 관계를 잇습니다.
위: 합성곱 — 3×3 창이 판을 훑으며 가까운 모양을 읽습니다. 아래: 어텐션 — 한 점이 361점 모두와 관계 점수를 매깁니다(선이 굵을수록 큰 점수).
낱말의 공간 (LLM)가장 가까운 점에 주목 → 가중치 → 다음 토큰의 확률바둑의 공간 (레벨 2)가장 닮은 모양에 주목 → 가중치 → 다음 수의 확률
어텐션의 같은 식이 두 세계에서 돈다. 낱말도 바둑 모양도 고차원 공간의 점(임베딩)이 되고, 질문이 뜨면 가장 가까운 점부터 선이 이어집니다. 선의 굵기가 가중치입니다.
AI의 방식 ①
판 전체를 한 번에
신경망은 급한 곳부터 차례로 보지 않습니다. 361개의 자리를 한 번에 보고, 모든 자리에 확률을 매깁니다. 어텐션 층은 멀리 떨어진 돌들 사이의 관계까지 한 번에 읽습니다.
AI의 방식 ②
격언보다 승률
AI에게 "어깨짚기는 나쁘다" 같은 격언은 없습니다. 이기는 확률이 높으면 낯선 수도 둡니다. 이른 3·3 침입처럼 프로 바둑의 상식을 바꾼 수들이 여기서 나왔습니다.
AI의 방식 ③
숫자로 말하는 근거
AI의 근거는 문장이 아니라 숫자입니다. 몇 번을 읽었고, 후보마다 승률과 집 차이가 얼마였는지. 워드고는 이 숫자를 사람의 말로 옮겨 해설합니다.
① 지금 판돌·활로·직전 수 등을 숫자 판으로② 겹겹의 신경망 층합성곱으로 가까운 모양, 어텐션으로 판 전체의 관계③ 답 두 개수마다 확률(밝을수록 유력) + 승률
감각이 고르고, 수읽기가 확인합니다
신경망은 판 전체를 한 번 보고 "고수라면 어디에 둘까"(수 확률)와 "지금 누가 이기고 있을까"(승률)를 동시에 냅니다. 이 한 번의 판단만으로도 강하지만, 가끔 몇 수 뒤의 함정을 놓칩니다. 그래서 워드고의 수읽기 엔진이 유력한 수부터 실제로 두어 보며, 상대의 응수까지 수백 번 읽어 판단을 확인합니다. 감각은 넓게 보고, 수읽기는 깊게 봅니다. 알파고 이후 강한 바둑 AI가 모두 쓰는 이 구조[2][3]를 워드고는 브라우저에서 도는 엔진으로 갖추고 있습니다. 기기의 힘을 먼저 재어 알맞은 크기의 신경망과 읽기 횟수를 고르고, 급수마다 읽기 횟수와 수 고르기를 조절해 18급부터 프로 9단까지 맞춥니다(엔진 조정).
AI의 방식합성곱 + 어텐션 신경망을 수읽기 엔진에 처음부터 연결
16승 0패대국실 프로 9단 설정 상대, 한 수 5초
내 PC에서WebGPU · WebAssembly, 기기 힘에 맞춰 크기를 고름
수마다 해설읽은 횟수 · 후보별 승률 · 예상 수순을 말로
측정 — 숫자로만 말합니다
레벨 2의 실력은 PlayBaduk 대국실의 '프로 6~9단 설정' AI와 둔 자동 대국으로 잽니다. 이 설정은 강한 신경망과 수읽기에 사람 후보를 섞은 상대로, 단계마다 약 110 엘로씩 강해집니다. 아래 그림은 실제 측정 결과를 그대로 다시 보여 주는 애니메이션입니다.
측정 조건: 같은 상대와 흑백을 번갈아 두고, 끝난 판은 강한 AI가 계가합니다. 마지막 줄(어텐션 신경망)은 그래픽 카드(RTX 3060)가 있는 서버의 브라우저 WebGPU에서 한 수 5초(약 700번 읽기)로 잰 값이라, 그래픽 카드가 없는 PC에서는 같은 시간에 읽는 횟수가 줄어듭니다. 공인 기력이 아닌 실험 측정치입니다(2026년 10월 30일).
왜 수마다 '왜'를 붙이는가
오늘의 LLM은 놀랍도록 말을 잘합니다. 그러나 그 말은 토큰과 토큰 사이의 통계에서 나옵니다. 어텐션은 "이 토큰 다음에 어떤 토큰이 올 확률이 높은가"를 계산할 뿐, 그 문장이 무엇을 뜻하는지, 왜 그 낱말이어야 하는지는 계산하지 않습니다. 그래서 LLM은 말을 잘하는 것처럼 보이지만, 실제로는 무엇을 말하는지 알지 못한 채 말합니다. 토큰 통계 위에서 어텐션을 쓰는 한, 그 안에서 '왜'를 꺼낼 수는 없습니다.
바둑 AI도 같습니다. 레벨 2의 신경망은 프로 9단 설정을 이길 만큼 강하지만, 그 수가 왜 좋은지는 승률이라는 숫자로만 압니다. 워드고가 모든 수에 이름과 이유를 붙이는 것은, 숫자 너머의 '왜'를 사람의 말로 세워 보려는 시도입니다. 레벨 2에서는 그 이유를 엔진이 정석 사전과 바둑 개념으로 사람의 관점에서 해설합니다. 그리고 그 다음 단계, AI가 스스로 '왜'를 아는 기계는 레벨 3이 풀려는 질문입니다. 씨엠씨테크는 스스로 인식하는 AI를 만들기 위해, 규칙이 닫혀 있고 답을 검증할 수 있는 바둑에서 이 방법을 먼저 실험하고 있습니다.
지금 위치: 목표는 프로 설정을 넘어 최강 AI와 대등해지는 것입니다. 첫 목표선(프로 9단 설정)은 그래픽 카드가 있는 환경에서 넘었고, 이제 그래픽 카드가 없는 회원 PC에서도 같은 기풍과 힘을 내도록 엔진을 조정하고 있습니다. 측정을 마치기 전까지 대국실의 레벨 2는 PlayBaduk 서버에서 둡니다.
CHAPTER 09
해설 — 내가 왜 이 수를 두었는지, 워드고는 스스로 말합니다
워드고의 이름은 Word + Go, 말하는 바둑입니다. 강한 수를 두는 것만으로는 부족합니다. 워드고는 수마다 정석 사전의 해설보다 한 걸음 더 친절하게, 초보도 알아듣는 말로 이름, 뜻, 다음 노림, 그리고 그 수를 고른 근거를 들려줍니다. 2장에서 말한 '왜 아는지 모르는 기계'와 정반대 자리에 서려는 것입니다.
2016. 3. 13 · 서울 · 알파고 대 이세돌 제4국
78수 다음, 아무도 이유를 몰랐던 수들
이세돌 9단의 78수가 나온 뒤, 알파고는 사람이 알아듣기 어려운 수를 잇달아 두었습니다. 해설자도 관객도 "버그인가?" 하고 물었습니다.
이 판은 이세돌 9단이 이겼습니다. 알파고를 만든 딥마인드는 뒤에 "알파고가 79수에서 실수했고, 87수쯤에야 그것을 알아챘다"고 밝혔습니다. 그런데 그 수를 왜 두었는지는, 알파고 자신도 말해 주지 못했습니다.
지금도 같습니다. 최신 AI 바둑 프로그램과 정상급 기사가 둔 판에서도, 사람이 왜 그 수인지 알아듣지 못하는 수가 나옵니다.
왜 말하지 못할까
신경망은 이유를 모릅니다
신경망은 수백만 판에서 뽑은 통계의 덩어리입니다. 대화형 AI(LLM)가 자기가 쓴 문장의 이유를 정확히 모르듯, 바둑 신경망도 자기 수의 이유를 모릅니다.
신경망이 내놓는 것은 "이 수의 승률 52%" 같은 숫자 하나입니다.
워드고의 길 — 로직이 말하고, 신경망이 보충합니다
① 레벨 1 · 로직
바둑의 개념을 코드로 짰습니다
돌, 집, 세력, 약한 무리, 차례, 수읽기, 정석. 바둑의 개념이 하나하나 코드로 들어 있습니다. 그래서 레벨 1은 자기가 계산한 그대로 이유를 말합니다.
② 레벨 2 · 신경망
이유 대신 길을 찾습니다
신경망에게는 이유를 묻지 않습니다. 후보 수마다 앞으로의 수순과 그 끝 장면, 곧 길을 찾게 합니다.
③ 로직이 길 끝을 읽습니다
신경망이 고른 수도 설명합니다
그 길의 끝 장면을 레벨 1의 로직이 다시 재어 말로 옮깁니다. 신경망 속을 들여다보는 것이 아니라, 길 끝을 잰 값을 말합니다.
지어내지 않습니다
두 판단이 같으면 확신을 갖고 말합니다. 다르면 다르다고 말합니다. 예를 들면 "로직은 A를, 신경망은 B를 골랐고, B의 길 끝이 약 3집 좋습니다." 로직의 추적만으로는 이유를 바로 잡을 수 없는 수도 나올 수 있습니다. 이런 경우 신경망이 놓은 자리를 중심으로 뻗어 갈 수 있는 수를 모두 따져 보고, 그 상황에서 가장 좋은 답을 찾아 그 이유를 들려줍니다.
워드고도 AI 바둑의 하나입니다. 다만 워드고는 가장 강한 바둑 AI를 향해 나아가면서, 왜 스스로 그곳에 두었는지 말하는 AI 바둑을 목표로 합니다. 현재 레벨 2는 공개 가중치를 쓰는 자체 엔진입니다.
해설 예시 · 백 C11 — 걸쳐 온 흑 한 점을 두 칸 떨어져 협공합니다.
이름
두칸 협공 · 왼쪽 변
뜻
흑이 C14로 걸쳐 오자, 백은 귀를 그냥 내주지 않고 아래쪽에서 두 칸 떨어져 흑 한 점을 압박합니다. 아래의 백 D4와도 손을 잡아 왼쪽 변 전체를 백의 땅으로 만들려는 수입니다.
다음
흑은 귀 3·3으로 들어가 살거나, 한 칸 뛰어 중앙으로 나와야 합니다. 어느 쪽이든 백은 정석대로 받으면서 바깥을 두텁게 쌓을 수 있습니다. 흑이 손을 빼면 백이 C14를 공격해 큰 이득을 봅니다.
근거
레벨 2 · 약 700번 수읽기 · 이 수의 승률 51%, 다음 후보 C12(한칸 협공) 48% · 설정 아마 1단: 아마 1단 기사가 자주 고르는 수 가운데 가장 좋은 수를 골랐습니다.
레벨 1의 해설
로직이 이유를 압니다
축이 되는지, 활로가 몇 개인지, 어느 정석의 몇 번째 수인지. 레벨 1은 계산한 사실을 그대로 말로 옮기므로, 이유를 지어내지 않습니다.
레벨 2의 해설
신경망의 판단도 숫자로
몇 번을 읽어 보았는지, 후보마다 승률과 집 차이가 얼마였는지, 지금 몇 급·몇 단으로 판단해 골랐는지까지 보여 줍니다.
초보의 눈높이
어려운 말은 풀어서
'두텁다', '맛이 나쁘다' 같은 바둑 말도 그 뜻을 함께 풀고, 다음에 무엇을 조심해야 하는지 한 줄로 알려 줍니다.
위 해설은 화면 구성을 보여 주는 예시입니다. 실제 대국에서는 그 판의 수읽기 결과로 해설이 만들어집니다.
CHAPTER 10
레벨 3 — ONI에서 LOM으로, 의미의 객체로 생각하는 바둑
워드고 레벨 3의 뿌리는 ONI(Object Net Intelligent)입니다. 씨엠씨테크가 1994년 아바토(ABBATO) 프로젝트에서 출발시킨 인지 연구로, 말을 뜻을 가진 객체들의 연결로 다루고 자신이 무엇을 하는지 그 이유를 참조할 수 있는 AI를 목표로 합니다. LOM(Large Object Model, 대규모 객체 모델)은 ONI와 별개의 출발점이 아니라, 이 목표를 LLM의 언어 처리 능력 위에서 다시 풀어가는 연구의 보조 명칭입니다.
처음에는 로직과 작은 구를 모은 자료에서 인지를 만들고, 그 위에 언어를 얹으려 했습니다. 이제는 이미 언어를 다루는 LLM에서 객체의 재료를 얻어 인지로 나아가는 방향입니다. 워드고는 이 생각을 바둑에 옮겨 어떤 모양과 관계를 판단했기에 이 수를 골랐는지를 수읽기와 함께 남기려 합니다.
① 출발점은 ONI — LLM에서 객체의 재료를 얻습니다
LLM은 문장을 토큰으로 나누고, 과 으로 문맥 속 관계를 계산합니다. ONI·LOM은 이 능력을 객체를 형성하는 출발점으로 활용합니다. 낱말뿐 아니라 구와 문장도 하나의 의미 단위가 될 수 있습니다.
그러나 토큰을 크게 묶고 그 위에 어텐션을 한 번 더 적용하는 것만으로는 충분하지 않습니다. 아바토 원고가 제안하는 핵심은 왜 모였는지와 무엇을 뜻하는지를 담은 인식, 그 뜻에 따라 판단하는 프로그램, 다른 객체와의 관계를 담은 신경선입니다. 객체가 커지는 것보다 객체가 무엇을 할 수 있는지가 중요합니다.
토큰은 언어 모델의 계산 단위입니다. ONI·LOM은 이 표현에서 의미 단위를 모으고, 목적과 판단 구조를 더한 객체를 구성하려 합니다.
② 객체 안에는 인식과 프로그램, 객체 사이에는 신경선
입력 → 의미 단위 → 인식·프로그램을 가진 객체 → 신경선의 판단 경로 → 결과와 이유 기록
인식(awareness)은 객체가 어떤 뜻과 목적으로 만들어졌는지를 판단에 사용하는 내부 정보입니다. 예를 들어 ‘창문을 열다’에는 상태를 바꾸고 공기를 통하게 한다는 뜻을 담습니다. 여기서 인식은 자신의 의미와 역할을 참조하는 기능을 가리킵니다.
프로그램(program)은 그 정보에 따라 받은 신호를 판단하는 논리입니다. 창문이 닫혀 있는지, 열면 바람이 통하는지, 바깥이 더 덥다면 다른 방법이 필요한지를 따집니다. 객체를 단순한 말 조각과 구별하는 것은 이 판단 기능입니다.
신경선(nerve line)은 원인·목적·부분·반대처럼 관계의 종류와 방향, 세기를 가진 연결입니다. 신호가 이 선을 따라 전해지면 각 객체의 프로그램이 맥락에 맞는지를 판단합니다. 객체 사이의 연결을 토큰 어텐션과 똑같은 계산으로 되풀이한다는 뜻이 아닙니다.
이유 기록(why trace)에는 어떤 객체가 어떤 관계와 조건 때문에 선택됐는지를 남깁니다. 나중에 ‘왜 그렇게 말했는가’를 물을 때 새 설명을 지어내는 대신 그 경로를 참조하려는 것입니다. 이 기록이 실제 판단 원인을 충실히 반영하도록 만드는 것이 설계의 핵심입니다.
구성
ONI·LOM의 개념
워드고에 옮긴 예
의미 단위
낱말·구·문장 등의 의미와 목적을 객체로 구성
돌무리·활로·연결·사활·정석의 관계
인식
객체의 뜻과 목적을 내부 정보로 참조
이 돌무리를 살리는가, 밖으로 나가는가
프로그램
받은 신호를 조건과 논리에 비추어 판단
연결이 실제로 되는지, 끊으면 잡히는지 수읽기
신경선
원인·목적·대안 등 관계를 가진 연결
연결 → 활로 확보 → 공격 회피의 경로
이유 기록
선택된 객체와 판단 경로를 남김
어느 약점을 해결하려고 이 후보를 골랐는지 설명
③ 워드고 레벨 3 — 수읽기와 ‘왜’를 같은 경로에
바둑에서 같은 모양도 주변 돌과 차례, 활로에 따라 뜻이 달라집니다. ‘연결하면 좋다’는 이름만 붙여서는 부족합니다. 어느 돌무리가 약한지, 연결이 성립하는지, 상대가 끊으면 어떻게 되는지를 객체의 조건과 판단으로 다루고, 관련 객체를 신경선으로 잇는 것이 레벨 3의 구상입니다.
예를 들어 두 돌무리 사이의 연결수를 검토한다면, 돌무리의 활로와 끊김 위험을 확인하고 상대의 응수까지 읽습니다. 그 결과 연결수를 골랐다면 해설도 ‘끊기면 위험한 두 무리를 연결해 활로를 확보하려는 수’라는 판단 경로에서 나오도록 설계합니다. 이는 적용 방향을 보여주는 예시이며, 모양의 이름만으로 좋은 수를 단정하는 방식은 아닙니다.
레벨 3은 신경망의 평가나 실제 수읽기를 없애려는 것이 아닙니다. 이들을 의미·조건·관계와 연결해 수를 고르는 과정과 그 수를 설명하는 근거가 이어지도록 하려는 연구입니다. ONI에서 이어 온 ‘자신의 판단과 이유를 참조하는 AI’라는 목표를 바둑에서 풀어가는 길입니다.
세 레벨은 실력의 계단이기 전에 생각하는 방식의 차이입니다. 레벨 1은 사람이 쌓아 온 지식을 규칙으로, 레벨 2는 데이터에서 얻은 통계를 감각으로, 레벨 3은 의미를 가진 객체를 단위로 바둑을 생각합니다. 아래 표는 그 차이를 같은 항목으로 나란히 놓은 것입니다. 특히 레벨 2는 왜 이 수를 두는지 사람의 관점에서 해설하는 바둑이고, 레벨 3은 수를 고른 판단 경로와 이유를 함께 남기려는 바둑입니다. 둘은 겉으로 비슷해 보여도 전혀 다른 개념입니다. 앞의 것은 엔진이 정석과 바둑 개념으로 이유를 붙여 주는 것이고, 뒤의 것은 객체의 의미·판단 프로그램·신경선 경로가 착수와 해설의 공통 근거가 되도록 하려는 구상입니다.
레벨 1 · 사람의 방식
레벨 2 · AI의 방식
레벨 3 · 객체의 방식(LOM)
한마디로
사람처럼 정석과 로직으로 두는 바둑
왜 이 수를 두는지 사람의 관점에서 해설하는 바둑
수를 고른 판단 경로와 이유를 함께 남기는 바둑을 지향
수를 고르는 원리
정석 → 급한 수 로직 → 기보 모양 → 수읽기
신경망(합성곱 + 어텐션)의 수 확률·승률 → 워드고 수읽기
의미·조건을 가진 객체의 프로그램이 신경선 경로와 수읽기를 함께 검토
지식의 출처
사람의 정석·격언·기보
대량의 대국으로 학습된 공개 가중치
ONI·LOM의 객체: 인식 + 프로그램 + 관계의 신경선
기풍
사람처럼 — 정석을 따르고 형태를 중시
AI처럼 — 승률이 가장 높은 길, 낯선 수도 서슴없이
모양의 의미와 성립 조건을 함께 판단하도록 설계
'왜'
계산한 사실(축·활로·정석 이름)을 말로
엔진이 정석·바둑 개념으로 해설 + 읽은 횟수·후보별 승률
객체의 판단과 선택 경로를 이유 기록으로 남기는 구상
신경망 가중치
쓰지 않음
합성곱 + 어텐션
신경망 표현을 객체 구성에 활용하고 프로그램·관계 구조를 결합
목표
아마 1급 → 아마 3단 → 최고 아마 5단
프로 설정을 넘어 최강 AI와 대등
수를 고른 관계와 이유를 되짚을 수 있는 바둑
지금 위치
3급과 대등 확인 · 아마 1단 목표 측정 중
프로 9단 설정에 16승 0패(그래픽 카드 환경)
ONI의 인지 구조를 바둑에 적용하는 연구
어디서 계산하나
회원 브라우저(WebAssembly)
회원 브라우저(WebGPU · WebAssembly), 측정 전에는 서버
객체 구성과 탐색 규모에 맞춰 실행 구조 설계
참고 문헌
Coulom, R. (2007). Computing "Elo Ratings" of Move Patterns in the Game of Go. ICGA Journal, 30(4), 198–208. — 레벨 1 기보 모양 학습의 계열.
Silver, D. et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529, 484–489.
Silver, D. et al. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359.
Vaswani, A. et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30.
McIlroy-Young, R., Sen, S., Kleinberg, J., Anderson, A. (2020). Aligning Superhuman AI with Human Behavior: Chess as a Model System. Proc. KDD 2020.
Shin, M., Kim, J., van Opheusden, B., Griffiths, T. L. (2023). Superhuman artificial intelligence can improve human decision-making by increasing novelty. PNAS, 120(12), e2214840120.
측정 숫자는 PlayBaduk이 자동 대국으로 잰 실험 측정치이며 공인 기력이 아닙니다(2026년 10월 30일 기준). ONI·LOM의 개념과 연구 방향은 아바토의 개념 원고에 정리되어 있습니다.
CHAPTER 12
다시, 그 2초
이제 처음의 2초를 다시 보면, 그 짧은 시간 안에 25년의 정석과 바둑 개념과 수만 판의 수읽기가 차례로 지나갑니다. 1994년의 '말을 아는 기계'라는 목표도 함께.
당신의 돌흑 Q16 화점
정석 사전여덟 방향으로 맞춰 보기 · 화점 응수 후보 4개
급한 수 로직단수·축·끊김 없음 → 큰 자리 찾기
수읽기수만 판을 끝까지 두어 보기
해설수 이름 · 뜻 · 예상 수순 · 승률을 문장으로
백 D4"마주 보는 화점으로 귀를 나눕니다"
GLOSSARY
용어 사전 — 뜻, 이력, 원 논문
본문에서 푸른 점선이 있는 낱말을 누르면 같은 창이 뜹니다. 각 항목에는 뜻과 역사, 그리고 원 논문이나 공식 자료의 링크가 있습니다. 링크는 새 창에서 열립니다.
EPILOGUE
다음 한 수는, 당신과 함께
워드고는 아직 자라는 중입니다. 오늘 밤에도 7호 서버는 새 기보를 두고 어제의 워드고와 오늘의 워드고를 맞붙여 보며, 8호 서버는 레벨 2를 급수마다 다듬습니다. 그리고 대국실에서 당신이 두는 한 판 한 판이 워드고가 배울 다음 이야기가 됩니다. 1994년에 시작한 '말을 아는 기계'의 이야기는 바둑판 위에서 계속됩니다.
표시한 실력은 PlayBaduk이 자동 대국으로 잰 실험 측정치이며 공인 기력이 아닙니다. 레벨 2 신경망은 공개된 바둑 AI 가중치를 씁니다. 출처와 라이선스는 AI·오픈소스 고지에 있습니다. 회사 역사는 씨엠씨테크 대표의 구술(2026년 10월)에 따랐으며, 인터넷 아카이브 저장본을 보면 확인할 수 있습니다. 측정 기록: 2026년 10월 30일 기준.